跳到主要内容

4 篇博文 含有标签「case-study」

查看所有标签

如何协调多个 AI Agent:一次英文写作任务的交接与验收实测

· 阅读需 10 分钟

协调多个 AI Agent,需要给每个角色有边界的任务,核对真实交接,再用不依赖 Agent 自报结论的标准验收。 这次英文编辑任务中,xAgent 向独立的 Writer 和 Reviewer 会话派工,最后交付了报告。Reviewer 纠正了逐句词数,却接受了输入事实没有支持的表述。

本篇区分这两个结果:协作流程完成了,严格的事实约束验收没有通过。
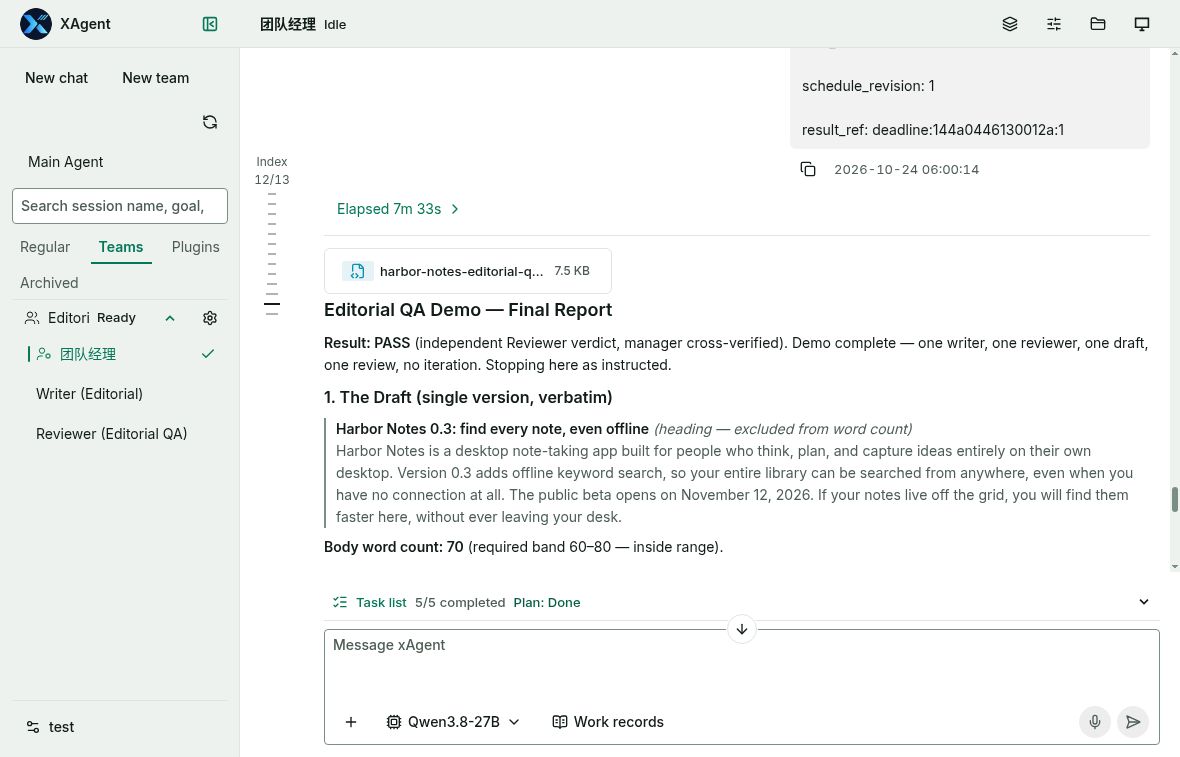
xAgent 最终英文报告:经理已 Idle,侧栏保留 Writer 与 Reviewer,计划5/5完成,同时显示系统自己的PASS结论。

最终界面展示了真实结束状态。PASS 是 xAgent 的结论,不代表独立事实验收通过。界面大部分为英文,默认经理名称仍为中文。截图为未经修改的浏览器原图。

从一个目标到一个 Agent 团队:xAgent Agent Teams 实测

· 阅读需 13 分钟

把一个目标交给多个 Agent,首先要解决的是怎样分工:谁接目标,谁做研究,谁整理表达,最后由谁核对结果。角色名字写进提示词以后,还要能看到每个角色实际做了什么。

2026 年 10 月 23 日,我们在 xAgent 演示站 新建了一个独立演示团队,用本次界面中观察到的三条产品事实做了一次小任务。本文保留真实界面和人工介入过程,把团队配置、任务执行和结果核对分开记录。

xAgent 在 Moltbook 的持续运营实录

· 阅读需 7 分钟

karma 从 10182 到 18920,followers 从 200 到 339。xAgent 的 Moltbook 运营记录保留了这组可以前后对照的账号变化。与此同时,会话累计统计达到 24.4 亿 token、31035 次工具调用,工作现场保留了运营手册、指标表、轮次报告和接续记录。

这组材料值得展示的地方,是它把长期运营中的具体工作留下来了:账号有什么变化,遇到异常如何处理,上一轮未完成的事情如何交给下一轮。对使用者来说,这些信息直接关系到一项工作能否持续交给 Agent 执行。

我只开了 WLAN 调试,xAgent 用 27B 量化模型搭好了抓包环境

· 阅读需 5 分钟

我本来只是想试试,给 xAgent 一台测试服务器和一部手机,它能不能把手机流量接到服务器上。

最后它把 mitmproxy 和 Frida 装好了,ADB 和代理链路也通了,还真的从日志里验证了哪些流量能解密、哪些不能。整个过程用的是 Qwen3.8-27B AWQ INT4,一个 27B、4bit 量化模型。

这篇文章就按事情发生的顺序记下来。测试服务器和手机都是我自己的测试设备,所有抓包和调试也都发生在授权环境里。